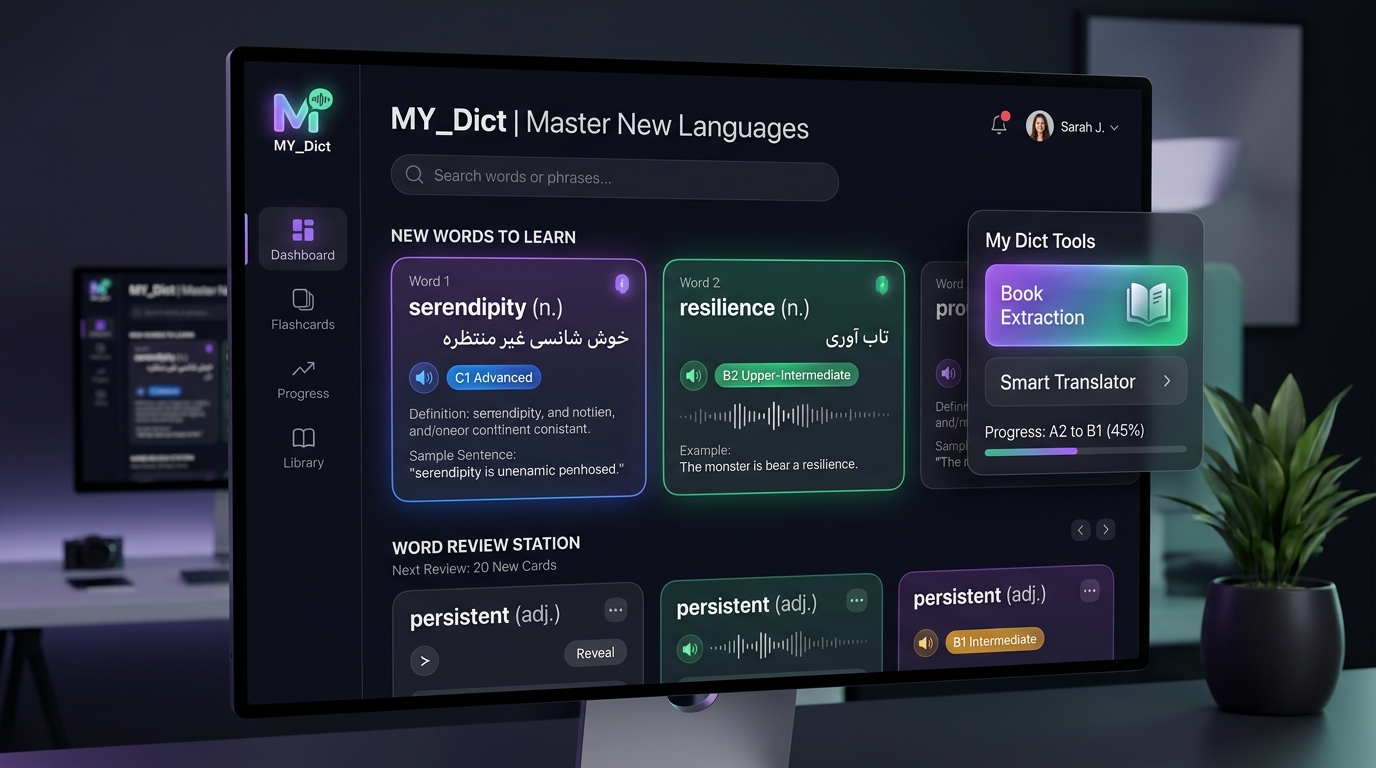
«مایدیکت (MY_Dict)» یک پلتفرم هوشمند و کاربردی برای افرادی است که با متون انگلیسی، کتابها، پادکستها یا فیلمهای زبان اصلی سر و کار دارند و میخواهند دایره لغات خود را بدون سردرگمی و اتلاف وقت ارتقا دهند.
معمولاً هنگام خواندن یک فایل PDF، کتاب الکترونیکی یا گوش دادن به یک فایل آموزشی، جستجوی تکتک لغات جدید در دیکشنریهای معمولی فرآیندی خستهکننده است؛ بدتر از آن، اکثر دیکشنریها معنی را خارج از بستر جمله نمایش میدهند و واژههای یادگرفتهشده نیز پس از چند روز به کلی فراموش میشوند.
مایدیکت تمام این مسیر را یکپارچه و لذتبخش کرده است: فایل کتاب، متن یا صوت را به سامانه میدهید؛ سیستم بلافاصله سطح دشواری متن را مشخص کرده و لغات جدید و کلیدی را جدا میکند، دقیقترین معنی هماهنگ با مفهوم متن را با هوش مصنوعی استخراج مینماید، و در نهایت واژهها را وارد «ایستگاه مرور هوشمند» میکند تا بر اساس سیستم تکرار فاصلهدار (Spaced Repetition) درست قبل از لحظه فراموشی به شما یادآوری شوند و برای همیشه در ذهن تثبیت گردند.
صورت مسئله و نیاز سازمان (The Problem)
زبانآموزان، دانشجویان و علاقمندان به مطالعه متون انگلیسی همواره با ۴ چالش رایج روبرو هستند:
۱. ندانستن سطح دشواری محتوا: آیا این مقاله یا کتاب مناسب سطح من است یا برایم بیش از حد سنگین و ناامیدکننده خواهد بود؟
۲. اتلاف وقت زیاد برای جستجوی تکتک لغات: توقف مداوم حین مطالعه کتاب یا گوش دادن به پادکست برای تایپ لغات ناشناخته در دیکشنری، تمرکز مطالعه را از بین میبرد.
۳. ترجمههای نامفهوم و تحتاللفظی: دیکشنریهای رایج معنی واژه را بدون در نظر گرفتن جمله و زمینه موضوعی ارائه میدهند که اغلب گیجکننده است.
۴. فراموشی سریع واژگان جدید: یادگیری لغت بدون یک برنامه مرور منظم بینتیجه است و بیش از ۸۰ درصد کلمات ظرف چند روز فراموش میشوند.
راهحل و قابلیتهای سامانه (The Solution)
مایدیکت یادگیری زبان را به یک چرخه هوشمند، لذتبخش و کاملاً کاربردی تبدیل کرده است:
• سنجش آنی سطح دشواری متن (CEFR): سیستم متن یا فایل شما را تحلیل کرده و درصد کلمات در سطوح A1 تا C2 را مشخص میکند تا دقیقاً بدانید متن در چه سطحی قرار دارد.
• استخراج خودکار لغات از انواع فرمتها: ورودی گرفتن مستقیم از کتابهای الکترونیکی (EPUB)، فایلهای PDF، فایلهای متنی و حتی فایلهای صوتی و ویدیویی بدون نیاز به تایپ دستی.
• فیلتر هوشمند کلمات بیاهمیت: سیستم کلمات تکراری و ابتدایی را به طور خودکار فیلتر کرده و فقط لغات ارزشمند را برای یادگیری به شما پیشنهاد میدهد.
• ترجمه دقیق و زمینهمحور با هوش مصنوعی: ترجمه روان و قابل فهم متناسب با بستر متن به همراه مثالهای ملموس و تلفظ صوتی.
• ایستگاه مرور هوشمند (ضد فراموشی): واژهها در دفترچه شخصی ذخیره شده و طبق الگوریتم تکرار فاصلهدار، در بهترین زمان برای مرور به شما پیشنهاد میشوند تا به حافظه بلندمدت منتقل گردند.
• رابط کاربری تمیز و ساده تحت وب: محیطی کاربرپسند با دسترسی راحت در موبایل و کامپیوتر همراه با امکان دستهبندی موضوعی لغات و خروجی گرفتن برای سایر ابزارها.
جریان کار و نحوه عملکرد سیستم (System Flow)
طراحی سامانه بر پایه معماری تمیز (Clean Architecture) به گونهای انجام شده که کار با آن برای کاربر نهایت سادگی را داشته باشد:
- رابط کاربری مدرن وب: پنل وب سبک و سریع با تم دارک و واکنشگرا برای مرور روزانه لغات و مدیریت دیتابیس شخصی.
- موتور پردازش و استخراج محتوا: استخراج متن و لغات از فایلهای PDF، EPUB و صوت با Speech-to-Text.
- هسته تحلیل سطح CEFR و تکرار فاصلهدار: ارزیابی دشواری متن بر اساس استانداردهای بینالمللی و زمانبندی مرور واژگان.
- موتور ترجمه هوشمند: تلفیق مدلهای زبانی Azure AI (GPT-4o) و گوگل با قابلیت چرخش خودکار کلیدها و پایداری بالا.
01
📚
۱. بارگذاری کتاب یا صوت
دریافت مستقیم کتابهای الکترونیکی، فایلهای PDF، متن یا فایل صوتی بدون نیاز به تایپ دستی.
02
📊
۲. سنجش سطح دشواری (A1-C2)
تحلیل آنی میزان سختی متن بر اساس سطوح استاندارد اروپایی جهت اطلاع از مناسب بودن محتوا.
03
🔍
۳. استخراج لغات کلیدی
فیلتر خودکار کلمات تکراری و ابتدایی و گلچین لغات ارزشمند و جدید برای یادگیری هدفمند.
04
🤖
۴. ترجمه مفهومی با AI
ارائه دقیقترین معنی واژه در بستر همان جمله، همراه با مثالهای ملموس و تلفظ صوتی.
05
🧠
۵. ایستگاه مرور (ضد فراموشی)
پیشنهاد هوشمند زمان مرور کلمات قبل از فراموشی طبق منحنی حافظه جهت تثبیت دائمی.
چالشهای فنی و نحوه حل آنها (Challenges & Solutions)
ترجمه دقیق اصطلاحات و کلمات چندمعنایی در بستر متن
صورت چالش
در متون انگلیسی بسیاری از لغات چند معنی کاملاً متفاوت دارند و دیکشنریهای معمولی معنایی ارائه میدهند که با موضوع متن همخوانی ندارد.
راهکار پیادهشده
اتصال سیستم به مدلهای زبانی هوش مصنوعی (GPT-4o) با تحلیل کل جمله و پاراگراف، تا دقیقترین و روانترین مفهوم متناسب با بستر متن ارائه شود.
دستاورد: درک کامل و بیابهام مفهوم واژهها و اصطلاحات خاص توسط کاربر.
جلوگیری از انباشتگی و فراموشی لغات جدید
صورت چالش
کاربران پس از استخراج دهها لغت از یک کتاب، بعد از چند روز اکثر آنها را فراموش میکنند چون نظم مشخصی برای مرور ندارند.
راهکار پیادهشده
پیادهسازی سیستم مرور با تکرار فاصلهدار (Spaced Repetition) که لغات دشوار را در فواصل نزدیکتر و لغات یادگرفتهشده را در فواصل طولانیتر به کاربر یادآوری میکند.
دستاورد: یادگیری عمیق و ماندگار در حافظه بلندمدت با صرف روزانه کمتر از ۵ دقیقه وقت مرور.
پشتیبانی از انواع فرمتهای مختلف بدون پیچیدگی برای کاربر
صورت چالش
کاربران تمایل دارند محتوا را از فایلهای مختلف مثل PDF کتاب، کتاب صوتی، یا فایل متنی استخراج کنند بدون اینکه درگیر خطاهای انکودینگ یا تبدیل فرمت شوند.
راهکار پیادهشده
یکپارچهسازی ماژولهای پردازش خودکار (pdfplumber, ffmpeg, speech-to-text) به صورتی که کاربر تنها فایل را آپلود میکند و نتیجه را مرتب و آماده تحویل میگیرد.
دستاورد: تجربه کاربری بسیار روان و صرفهجویی چشمگیر در وقت بدون نیاز به ابزارهای جانبی.
دستاوردها و نتایج کلیدی (Results & Impact)
• صرفهجویی بیش از ۷۰ درصدی در زمان یادگیری لغات جدید از کتابها، مقالات و پادکستها.
• تحلیل فوری سطح دشواری متن با طبقهبندی استاندارد CEFR (A1 تا C2).
• ارتقای چشمگیر ماندگاری واژگان در ذهن به کمک ایستگاه مرور تکرار فاصلهدار.
• ترجمه دقیق و متناسب با موضوع به لطف هوش مصنوعی پیشرفته GPT-4o.
• خروجی و پشتیبانگیری آسان از لغات شخصی در قالب فایلهای اکسل/CSV و کدهای اشتراکگذاری سریع.